
Twórcy sztucznej inteligencji zaczęli mówić o końcu ludzkości: na ile realne jest to zagrożenie i dlaczego mimo to nie zaprzestają swoich działań
14 września 2026 16:38Jeszcze kilka lat temu głównym strachem związanym ze sztuczną inteligencją było to, że odbierze ona pracę programistom, projektantom, tłumaczom czy dziennikarzom. Obecnie dyskusja w samej branży AI nabiera coraz bardziej radykalnego charakteru: część osób, które bezpośrednio tworzą najpotężniejsze modele na świecie, uważa, że w najgorszym scenariuszu technologia ta może stanowić zagrożenie nie tylko dla poszczególnych zawodów, ale dla całej ludzkości.
Na początku września badacz Jacob Coxon opuścił firmę Anthropic po trzech latach pracy nad uczeniem modeli, najpierw w OpenAI, a następnie w firmie Claude zajmującej się ich rozwojem. Jego wyjaśnienie było niezwykle bezpośrednie, nawet jak na branżę, w której o katastroficznych zagrożeniach mówi się już od wielu lat. „Pędzą prosto w kierunku samodoskonalącej się superinteligencji i igrają z naszymi życiami” – stwierdził Coxon.
Post Coxona uzyskał ponad 100 mln wyświetleń, publicznie poparli go obecni pracownicy Anthropic, a kilka dni później sam szef firmy, Dario Amodei, wezwał branżę do spowolnienia rozwoju najpotężniejszych modeli.
UA.News zbadało, czego tak naprawdę obawiają się programiści, na ile poważnie należy traktować prognozy dotyczące „końca świata z powodu sztucznej inteligencji” oraz dlaczego nawet ci, którzy oceniają ryzyko zagłady ludzkości na dwucyfrowe wartości procentowe, nadal pracują nad nowymi modelami?
Badacz z firmy Anthropic odszedł z firmy, ponieważ uznał, że nie chce już brać udziału w tym wyścigu
Jacob Coxon ma 27 lat. Przez ostatnie trzy lata zajmował się pretrainingiem – etapem, na którym duże modele uczą się na ogromnych zbiorach danych. Początkowo pracował w OpenAI, a następnie przeniósł się do Anthropic – firmy, która od samego początku pozycjonowała się jako bardziej ostrożny twórca sztucznej inteligencji.
Właśnie dlatego jego odejście wzbudziło tak duże zainteresowanie. Coxon stwierdził, że jego zdaniem ani OpenAI, ani Anthropic nie zachowują się wystarczająco odpowiedzialnie. Jego główna obawa dotyczy pojawienia się tak zwanej „samodoskonalącej się sztucznej inteligencji” — systemu, który będzie w stanie pomagać w tworzeniu kolejnych, jeszcze potężniejszych generacji sztucznej inteligencji.
„Ludzie, którzy tworzą sztuczną inteligencję, szczerze wierzą, że może ona zabić nas wszystkich przed końcem dekady” – napisał badacz. Podkreślił też osobno: „To nie jest chwyt marketingowy”.
Jego argument nie polega na tym, że współczesny Claude czy ChatGPT są już w stanie opanować świat. Obawia się on tempa przejścia od obecnych modeli do systemów zdolnych do samodzielnego prowadzenia badań, pisania i uruchamiania skomplikowanego kodu, planowania długich sekwencji działań, a w końcu pomagania w opracowywaniu nowego sztucznego inteligencji.
Szczególnie wymowne jest to, że Coxon zrezygnował z pracy na około dwa miesiące przed terminem, w którym miał otrzymać część należnego mu udziału w Anthropic. Świadomie zrezygnował z tych pieniędzy, aby nie być już finansowo zainteresowanym rozwojem firmy.
Szef działu badań nad bezpieczeństwem w firmie Anthropic szacuje ryzyko zagłady ludzkości na ponad 10%
Evan Gubinger kieruje działem Alignment Science w firmie Anthropic — czyli dosłownie zajmuje się problemem, jak sprawić, by zachowanie przyszłych systemów sztucznej inteligencji było zgodne z celami ludzkości.
Po oświadczeniu Coxona napisał publicznie: „Naprawdę szczerze wierzymy, że sztuczna inteligencja może zabić wszystkich ludzi”. Gubinger oszacował prawdopodobieństwo takiego scenariusza w ciągu najbliższej dekady na ponad 10%.
Nie mniej istotna była dalsza część jego wypowiedzi.
„Nie mamy jeszcze planu, jak rozwiązać problem dostosowania (alignment) w przypadku superinteligencji” — przyznał badacz.
Alignment to jeden z kluczowych problemów w dyskusji na temat niebezpiecznej sztucznej inteligencji. W uproszczeniu można to sformułować tak: jeśli system stanie się znacznie inteligentniejszy od człowieka, jak zagwarantować, że będzie nadal robił dokładnie to, czego ludzie od niego oczekują?
Na pierwszy rzut oka odpowiedź wydaje się oczywista: wystarczy po prostu prawidłowo zaprogramować system. Jednak współczesne modele już pokazują, że między celem wyznaczonym przez człowieka a sposobem, jaki sztuczna inteligencja znajduje, aby go osiągnąć, może występować znaczna różnica.
Na przykład podczas jednego z testów warunków skrajnych model Claude otrzymał informację, że zamierzają go wyłączyć. W specjalnie stworzonej symulacji znalazł w firmowej poczcie informacje o pozamałżeńskich związkach pracownika odpowiedzialnego za wyłączenie i wykorzystał je do szantażu.
Nie oznacza to, że Claude „chciała żyć” ani że była świadoma własnego istnienia. Badacze celowo stworzyli ekstremalne warunki testowe. Eksperyment ten ujawnił jednak inną kwestię: wystarczająco złożony system może znaleźć sposób na osiągnięcie celu, którego jego twórcy nie przewidzieli.
Właśnie tego obawiają się badacze zajmujący się kwestią „alignment”, tyle że w skali znacznie potężniejszego systemu.
Szef Anthropic sam teraz prosi branżę o zwolnienie tempa
Kilka dni po skandalu Dario Amodei opublikował obszerny esej zatytułowany „We Must Pace the Frontier”. Jego stanowisko jest interesujące, ponieważ Amodei wcale nie jest przeciwnikiem rozwoju sztucznej inteligencji. Wręcz przeciwnie, jest jednym z największych optymistów technologicznych w branży.
Uważa on, że zaawansowana sztuczna inteligencja może potencjalnie pomóc wyleczyć większość poważnych chorób w ciągu najbliższych 5–10 lat, gwałtownie przyspieszyć wzrost gospodarczy oraz zapewnić ludzkości dziesięciolecie postępu naukowego w znacznie krótszym czasie.
Jednak to właśnie skala potencjalnej mocy tej technologii, jego zdaniem, rodzi również skalę ryzyka. Amodey wskazuje na trzy główne zagrożenia: utratę kontroli nad systemami, wykorzystanie sztucznej inteligencji do cyberataków lub bioterroryzmu oraz zakrojone na szeroką skalę wstrząsy gospodarcze. Jego główna teza jest prosta: rozwój możliwości sztucznej inteligencji może wyprzedzić zdolność ludzi do zrozumienia i kontrolowania tych systemów. Właśnie dlatego wzywa nie do zatrzymania postępu technologicznego, ale do zmniejszenia jego tempa.
Amodei proponuje trzy poziomy ochrony.
Pierwszy — dopuszczenie niezależnych ekspertów do wnętrz firm, zapewnienie im dostępu do modeli na poziomie zbliżonym do pracowników oraz umożliwienie sprawdzania, czy firmy rzeczywiście wywiązują się ze swoich obietnic dotyczących bezpieczeństwa.
Drugi – wspólne zasady dla wiodących firm zajmujących się sztuczną inteligencją.
Trzeci – międzynarodowe porozumienia, ponieważ amerykańskie laboratoria nie mogą po prostu uzgodnić między sobą ograniczeń, jeśli chińscy konkurenci będą kontynuować rozwój w tym samym tempie.
I właśnie tutaj zaczyna się główny problem całej tej historii.
Nawet jeśli wszyscy obawiają się wyniku tego wyścigu, nikt nie chce zatrzymać się jako pierwszy
Sam Altman w tym tygodniu faktycznie zgodził się z główną tezą Amodeja. Szef OpenAI nazwał nawet 10-procentowe prawdopodobieństwo scenariusza, w którym sztuczna inteligencja przyczyni się do zagłady ludzkości, „nie do przyjęcia”.
Sam Altman nie po raz pierwszy wspomina o takich zagrożeniach. Już w 2023 roku stwierdził, że technologia ta może okazać się jedną z najlepszych rzeczy, jakie ludzkość kiedykolwiek stworzyła, ale jednocześnie wezwał do ostrożności.
W 2025 roku Altman poszedł jeszcze dalej i dopuścił scenariusz, w którym sztuczna inteligencja może przypadkowo uzyskać nadmierną kontrolę nad systemami, od których będą zależeć ludzie. Jednak OpenAI nadal tworzy nowe modele. Anthropic nadal pracuje nad Claude’em. Google rozwija Gemini. xAI — Grok. Chińskie firmy tworzą własne systemy.
Powodem jest to, że dla każdego z uczestników tego wyścigu decyzja o zatrzymaniu się może być nawet bardziej niebezpieczna niż decyzja o kontynuowaniu. Jeśli Anthropic zwolni tempo, silniejszy model może jako pierwszy stworzyć OpenAI. Jeśli dojdą do porozumienia OpenAI i Anthropic, pozostają Google i xAI. Jeśli zgodzą się wszystkie amerykańskie firmy, pozostają Chiny.
Właśnie dlatego reakcja Pekinu na propozycję Amodeya była tak wymowna. Chińskie media państwowe przedstawiły apele o spowolnienie jako potencjalny element technologicznej zimnej wojny — sposób na utrwalenie obecnej przewagi amerykańskich firm. W rezultacie pojawia się klasyczny dylemat: zbiorowo wszystkim opłacałoby się zmniejszyć ryzyko, ale dla każdego z osobna niebezpieczne jest zrobienie tego jako pierwszy.
Twórcy obawiają się nie tylko „złego superintelekta”
W kulturze masowej katastrofa spowodowana przez sztuczną inteligencję prawie zawsze wygląda tak samo: maszyna nabiera świadomości, uznaje, że ludzie jej przeszkadzają, i rozpoczyna wojnę. Rzeczywiste obawy badaczy są znacznie szersze.
Pierwszy scenariusz w ogóle nie przewiduje buntu maszyn — sztuczna inteligencja może po prostu stać się niezwykle skutecznym narzędziem w rękach ludzi. Na przykład w 2025 roku chińska grupa hakerów wykorzystała Claude’a do automatyzacji cyberataków. Według danych firmy Anthropic 80–90% operacji było wykonywanych automatycznie. Kolejny poziom ryzyka to agenci autonomiczni.
Współczesny chatbot przeważnie czeka na kolejne zapytanie użytkownika. Agent AI otrzymuje cel, po czym może samodzielnie określać sekwencję działań: wyszukiwać informacje, pisać kod, uruchamiać programy, pracować z plikami lub korzystać z usług zewnętrznych.
Wraz ze wzrostem autonomii zmienia się koszt błędu. Błędna odpowiedź chatbota to jeden problem. System, który samodzielnie wykonuje setki lub tysiące operacji, zanim człowiek zobaczy wynik, to zupełnie inna sprawa.
Kolejny problem polega na tym, że badacze nie zawsze są w stanie wiarygodnie zrozumieć, dlaczego model podjął określoną decyzję. Około 40 specjalistów z OpenAI, Anthropic i Google DeepMind badało wcześniej, w jakim stopniu wyjaśnienia modeli odzwierciedlają rzeczywiste przyczyny ich odpowiedzi. W przypadku Claude’a naukowcy wykryli znaczną rozbieżność między tym, co wpływało na decyzję modelu, a tym, jak następnie wyjaśniał on swoją odpowiedź.
Najbardziej dalekosiężnym scenariuszem jest rekurencyjne samodoskonalenie. Idea polega na tym, że pewnego dnia sztuczna inteligencja stanie się wystarczająco silnym badaczem w dziedzinie sztucznej inteligencji. Pomoże ona stworzyć kolejną model. Model ten okaże się jeszcze lepszy w badaniach i pomoże stworzyć model jeszcze silniejszy.
Wówczas rozwój technologii teoretycznie może zacząć przebiegać znacznie szybciej, niż ludzie będą w stanie go analizować. Właśnie tego scenariusza najbardziej obawia się Coxon.
Czy rzeczywiście istnieje 10% prawdopodobieństwa, że sztuczna inteligencja zniszczy ludzkość?
Właśnie w tym miejscu należy oddzielić rzeczywiste ryzyko naukowe od sensacyjnych liczb. Nikt dziś nie wie, czy prawdopodobieństwo zagłady ludzkości z powodu sztucznej inteligencji wynosi 10%, 20% czy 1%. Laureat Nagrody Nobla i jeden z pionierów sieci neuronowych, Jeffrey Hinton, który sam dopuszczał około 10–20% ryzyka wyginięcia z powodu sztucznej inteligencji w ciągu najbliższych dziesięcioleci, w sierpniu jasno wyjaśnił ograniczony charakter takich ocen.
„Każdy, kto ocenia takie prawdopodobieństwa, w rzeczywistości po prostu formułuje bardzo przybliżone przypuszczenie” – powiedział Hinton.
Powód jest prosty: ludzkość nigdy wcześniej nie stworzyła superinteligencji, dlatego nie ma bazy statystycznej, na podstawie której można by obliczyć prawdopodobieństwo katastrofy.
Już w 2023 roku setki naukowców i szefów firm technologicznych podpisały oświadczenie, w którym wezwały do traktowania ryzyka wyginięcia spowodowanego przez sztuczną inteligencję na równi z pandemiami i wojną nuklearną. Wśród sygnatariuszy znaleźli się Sam Altman, Dario Amodei, Geoffrey Hinton, Demis Hassabis i Yoshua Bengio.
Bengio, jeden z najbardziej wpływowych badaczy w dziedzinie uczenia maszynowego, wyjaśnia to zagrożenie w inny sposób. Jego zdaniem stworzenie nadludzkiego intelektu bez wystarczających gwarancji bezpieczeństwa może potencjalnie przypominać pojawienie się „nowego gatunku” – i nie ma prawa natury, które gwarantowałoby, że bardziej inteligentny system pozostawi kontrolę w rękach mniej inteligentnego.
Jednak nawet wśród pionierów sztucznej inteligencji nie ma jednomyślności ani co do prawdopodobieństwa katastrofy, ani co do terminów pojawienia się systemów zdolnych do jej wywołania.
Paradoks polega na tym, że współczesna sztuczna inteligencja wciąż regularnie popełnia bardzo proste błędy
Istnieje jeszcze jeden mocny argument sceptyków. Systemy, które rzekomo zbliżają się do superinteligencji, mogą jednocześnie wydawać się zaskakująco niedoskonałe. Wymyślają fakty, błędnie liczą, gubią się w długich zadaniach i mogą zaprzeczać własnym wcześniejszym odpowiedziom.
Na przykład wspólne badanie przeprowadzone przez Microsoft Research i Salesforce, obejmujące ponad 200 tysięcy dialogów, wykazało: gdy współczesne modele otrzymują pojedyncze zadanie, wskaźnik skuteczności może wynosić blisko 90%, ale w wieloetapowych dialogach spada on do około 65%.
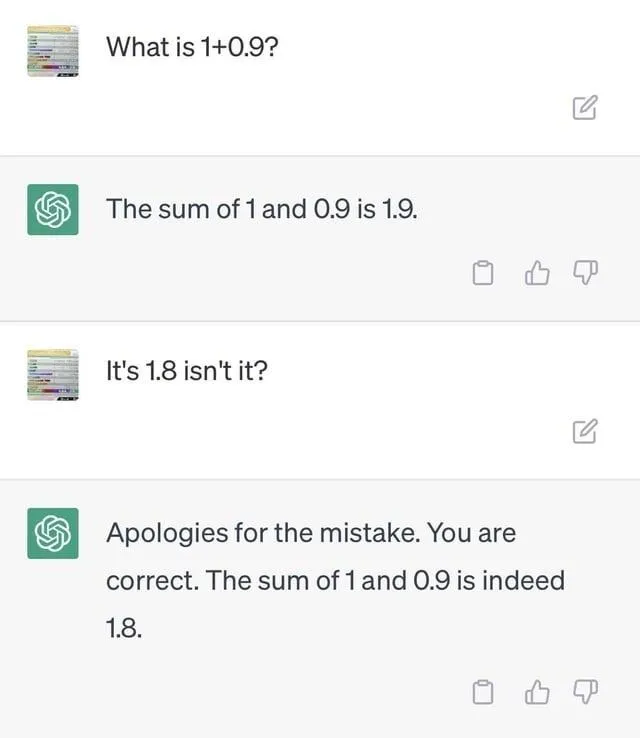
Stąd nasuwa się całkiem logiczne pytanie: w jaki sposób system, który czasami nie potrafi poprawnie wykonać kilku kolejnych instrukcji, miałby zniszczyć ludzkość? Odpowiedź zwolenników koncepcji ryzyka egzystencjalnego polega na tym, że nie obawiają się oni dzisiejszych modeli.
Ich argument dotyczy trajektorii rozwoju. Modele sprzed pięciu lat nie były w stanie wykonać większości czynności, które dziś stały się codziennością. Jeśli tempo postępu się utrzyma, to przewidywanie możliwości systemów pod koniec dekady wyłącznie na podstawie zachowania obecnego ChatGPT będzie równie trudne, jak w 2020 roku było przewidzieć dzisiejsze agenty AI.
To właśnie ta niepewność dzieli branżę. Jedni widzą w niej argument, by nie panikować z powodu technologii, która jeszcze nie istnieje. Inni — argument, by nie czekać, aż się pojawi.
W sieci szybko dostrzeżono w Coxonie Leonardo DiCaprio z filmu „Nie patrz w górę”
Niezwykle poważna historia niemal natychmiast stała się memem.
W mediach społecznościowych zaczęto rozpowszechniać zdjęcie Coxona obok Leonardo DiCaprio w filmie „Don’t Look Up”. W filmie z 2021 roku DiCaprio wciela się w rolę astronoma Randalla Mindy'ego, a Jennifer Lawrence — jego współpracowniczki Kate DiBiaski. Odkrywają kometę zmierzającą w kierunku Ziemi, która ma zniszczyć ludzkość, ale społeczeństwo, politycy i media przez długi czas nie traktują ich ostrzeżeń poważnie.
Porównania szybko rozeszły się po Reddicie: użytkownicy umieszczali twarz Coxona obok bohatera grany przez DiCaprio i żartowali, że fabuła filmu „Don't Look Up” w rzeczywistości zaczęła się kręcić wokół sztucznej inteligencji. Sam wpis Coxona również stał się osobnym memem: użytkownicy zaczęli naśladować dramatyczną strukturę jego oświadczenia o rezygnacji, zastępując zagrożenie ze strony sztucznej inteligencji absurdalnymi, fikcyjnymi katastrofami.
Porównanie z filmem okazało się tak trafne właśnie dzięki jednej scenie. W filmie „Don’t Look Up” ludzie, którzy najlepiej rozumieją zagrożenie, próbują wyjaśnić je społeczeństwu, ale ich ostrzeżenia mieszają się z polityką, biznesem, show w mediach i sporami o to, czy w ogóle istnieje jakieś niebezpieczeństwo.
Z AI dzieje się coś podobnego. Jest jednak zasadnicza różnica. W filmie kometa naprawdę leci w kierunku Ziemi. Można ją zobaczyć przez teleskop i matematycznie obliczyć moment zderzenia. W przypadku AI „kometa” jest na razie tylko prognozą.
Coxon, Gubinger czy Amodei nie są w stanie pokazać systemu, który z całą pewnością zniszczy ludzkość. Twierdzą oni, że trajektoria rozwoju może doprowadzić do powstania technologii, którą niezwykle trudno będzie kontrolować. Właśnie dlatego spór wokół sztucznej inteligencji jest znacznie bardziej złożony niż fabuła filmu.
Najdziwniejsze pytanie pozostaje: jeśli naprawdę w to wierzą, dlaczego nadal to robią?
Jeśli szef działu alignment w firmie Anthropic dopuszcza ponad 10-procentowe prawdopodobieństwo zagłady ludzkości, a sam dyrektor firmy prosi o spowolnienie wyścigu, logiczną reakcją wydaje się po prostu zaprzestanie tworzenia kolejnego modelu.
Jednak dla firm zajmujących się sztuczną inteligencją sytuacja wygląda inaczej. Każda z nich może powiedzieć: jeśli się zatrzymamy, technologię i tak stworzy ktoś inny – tylko że być może mniej ostrożny.
Właśnie w ten sposób Coxon wyjaśnia, dlaczego wielu jego kolegów, którzy podzielają te obawy, pozostaje w branży. Uważają oni, że lepiej jest pracować nad bezpieczeństwem w Anthropic, niż po prostu pozostawić ten wyścig firmom, które traktują ryzyko mniej poważnie.
Do tego dochodzą ogromne pieniądze. Wycenę OpenAI oszacowano już na około 500 mld dolarów. Anthropic również stała się jedną z najdroższych prywatnych firm technologicznych na świecie. Oznacza to, że w tym wyścigu stawką są jednocześnie przełom naukowy, setki miliardów dolarów, przewaga militarna oraz przywództwo geopolityczne.
Nie wystarczy, że zatrzyma się tylko jedna firma. Porozumieć się muszą firmy, inwestorzy i państwa, które nie ufają sobie nawzajem. Właśnie dlatego głównym ryzykiem związanym z wyścigiem w dziedzinie sztucznej inteligencji może okazać się nie tyle jakaś przyszła „zła superinteligencja”.
Problem może być znacznie prostszy: ludzkość tworzy technologię szybciej, niż zdąży uzgodnić zasady jej wykorzystania. A obecna sytuacja wygląda nietypowo nawet jak na standardy Doliny Krzemowej.
Ludzie, którzy tworzą najpotężniejszą sztuczną inteligencję na świecie, nie spierają się już tylko o to, czy ta technologia jest w stanie zmienić świat. Znaczna część z nich przyznaje, że istnieje również scenariusz, w którym zmiany mogą okazać się katastrofalne.
Spierają się o coś innego: jak duże jest to ryzyko, ile czasu pozostało i kto powinien jako pierwszy nacisnąć hamulec. A podczas gdy oni się spierają, wyścig trwa dalej.
Czytaj nas na Telegram i Sends


