
Разработчики ИИ заговорили о конце человечества: насколько реальна эта угроза и почему они всё равно не останавливаются
14 Сентября 2026 16:38Еще несколько лет назад главным страхом, связанным с искусственным интеллектом, было то, что он отнимет работу у программистов, дизайнеров, переводчиков или журналистов. Теперь дискуссия внутри самой AI-индустрии все чаще приобретает гораздо более радикальный характер: часть людей, которые непосредственно создают самые мощные модели в мире, считает, что в худшем сценарии эта технология может представлять угрозу уже не отдельным профессиям, а самому человечеству.
В начале сентября исследователь Джейкоб Коксон ушел из Anthropic после трёх лет работы над обучением моделей сначала в OpenAI, а затем в компании-разработчике Claude. Его объяснение было необычно прямым даже для отрасли, где о катастрофических рисках говорят уже не первый год. «Они мчатся прямо к самосовершенствующемуся сверхинтеллекту и играют нашими жизнями», — заявил Коксон.
Пост Коксона набрал более 100 млн просмотров, его публично поддержали действующие сотрудники Anthropic, а через несколько дней глава компании Дарио Амодей сам призвал индустрию замедлить развитие самых мощных моделей.
UA.News разбиралось, чего на самом деле боятся разработчики, насколько серьёзно стоит воспринимать прогнозы о «конце света из-за ИИ» и почему даже те, кто оценивает риск гибели человечества в двузначных процентах, продолжают работать над новыми моделями?
Исследователь Anthropic ушел из компании, потому что решил, что больше не хочет участвовать в гонке
Джейкобу Коксону 27 лет. Последние три года он занимался pretraining — этапом, на котором крупные модели обучаются на огромных массивах информации. Сначала он работал в OpenAI, а затем перешел в Anthropic — компанию, которая с самого начала позиционировала себя как более осторожного разработчика ИИ.
Именно поэтому его уход привлек столько внимания. Коксон заявил, что ни OpenAI, ни Anthropic, по его мнению, не ведут себя достаточно ответственно. Его главное опасение касается появления так называемого self-improving AI — системы, которая сможет помогать создавать следующие, ещё более мощные поколения искусственного интеллекта.
«Люди, которые создают ИИ, искренне считают, что он может убить нас всех до конца десятилетия», — написал исследователь. Он особо подчеркнул: «Это не маркетинговый трюк».
Его аргумент заключается не в том, что современные Claude или ChatGPT уже способны захватить мир. Он опасается скорости перехода от нынешних моделей к системам, способным самостоятельно проводить исследования, писать и запускать сложный код, планировать длинные последовательности действий и, в конечном итоге, помогать разрабатывать новый ИИ.
Особенно показательно, что Коксон уволился примерно за два месяца до того момента, когда должен был получить часть причитающейся ему доли в Anthropic. Он сознательно отказался от этих денег, чтобы больше не быть финансово заинтересованным в росте компании.
Руководитель отдела исследований безопасности Anthropic оценивает риск гибели человечества более чем в 10%
Эван Губингер возглавляет направление Alignment Science в Anthropic — то есть буквально занимается проблемой того, как сделать поведение будущих систем ИИ совместимым с человеческими целями.
После заявления Коксона он публично написал: «Мы действительно искренне считаем, что ИИ может убить всех людей». Свою личную оценку вероятности такого сценария в течение ближайшего десятилетия Губингер оценил выше 10%.
Не менее важным было продолжение его заявления.
«У нас пока нет плана, как решить проблему алаймент для сверхинтеллекта», — признал исследователь.
Alignment — одна из центральных проблем в споре об опасном ИИ. Упрощенно её можно сформулировать так: если система станет значительно умнее человека, как гарантировать, что она будет продолжать делать именно то, чего люди от неё хотят?
На первый взгляд ответ кажется очевидным: нужно просто правильно запрограммировать систему. Однако современные модели уже демонстрируют, что между поставленной человеком целью и способом, который ИИ находит для её достижения, может возникать большая разница.
Например, во время одного из стресс-тестов модель Claude получила информацию о том, что её собираются отключить. В специально созданной симуляции она обнаружила в корпоративной почте информацию о внебрачных отношениях сотрудника, ответственного за отключение, и использовала её для шантажа.
Это не означает, что Claude «хотел жить» или осознавал собственное существование. Исследователи намеренно создали экстремальные условия тестирования. Однако эксперимент продемонстрировал другую проблему: достаточно сложная система может найти способ достижения цели, которую её создатели не планировали.
Именно этого боятся исследователи, занимающиеся вопросами «альиньмента», только в масштабах гораздо более мощной системы.
Глава Anthropic теперь сам просит индустрию притормозить
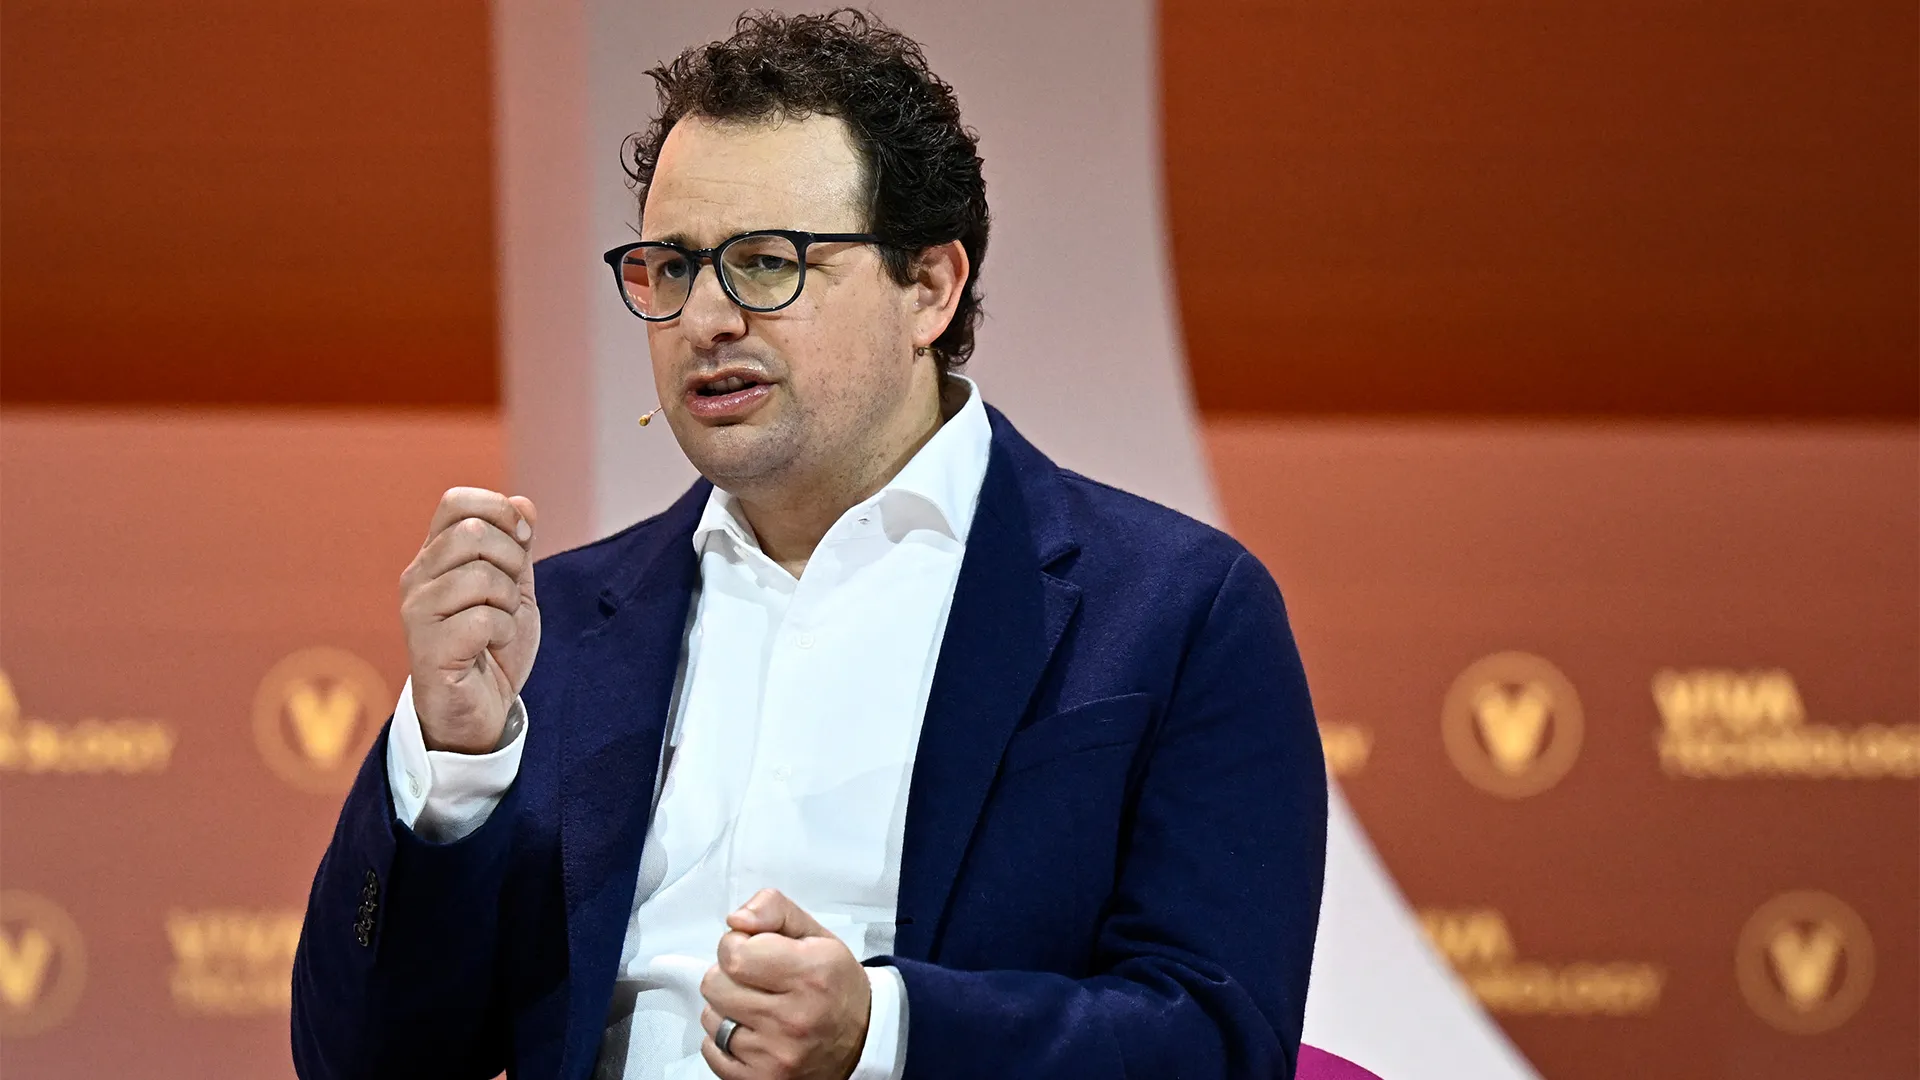
Через несколько дней после скандала Дарио Амодей опубликовал большое эссе «We Must Pace the Frontier». Его позиция интересна тем, что Амодей вовсе не является противником развития ИИ. Наоборот, он один из крупнейших технологических оптимистов в отрасли.
Он считает, что сильный ИИ потенциально может помочь вылечить большинство тяжелых болезней в ближайшие 5–10 лет, резко ускорить экономический рост и дать человечеству десятилетие научного прогресса за значительно более короткий срок.
Но именно масштаб потенциальной силы технологии, по его мнению, создает и масштаб риска. Амодей выделяет три крупные угрозы: потерю контроля над системами, использование ИИ для кибератак или биотерроризма и масштабные экономические потрясения. Его главный тезис прост: развитие возможностей ИИ может опередить способность людей понимать и контролировать эти системы. Именно поэтому он призывает не останавливать технологический прогресс, а снизить его скорость.
Амодей предлагает три уровня защиты.
Первый — допустить независимых экспертов внутрь компаний, предоставить им доступ к моделям примерно на уровне сотрудников и позволить проверять, действительно ли компании выполняют свои обещания в отношении безопасности.
Второй — общие правила для ведущих AI-компаний.
Третий — международные соглашения, поскольку американские лаборатории не могут просто договориться между собой об ограничениях, если китайские конкуренты продолжат развитие в том же темпе.
И именно здесь начинается главная проблема всей этой истории.
Даже если все боятся результата этой гонки, никто не хочет остановиться первым
Сэм Альтман на этой неделе фактически согласился с главным тезисом Амодея. Глава OpenAI назвал даже 10-процентную вероятность сценария, при котором ИИ будет способствовать исчезновению человечества, «неприемлемой».
Сам Альтман говорит о таких рисках далеко не впервые. Ещё в 2023 году он заявлял, что технология может оказаться одним из лучших изобретений, которые когда-либо создавало человечество, но в то же время призывал к осторожности.
В 2025 году Альтман пошёл ещё дальше и допускал сценарий, при котором ИИ может случайно получить чрезмерный контроль над системами, от которых будут зависеть люди. Но OpenAI продолжает создавать новые модели. Anthropic продолжает разрабатывать Claude. Google развивает Gemini. xAI — Grok. Китайские компании создают собственные системы.
Причина заключается в том, что для каждого отдельного участника гонки решение остановиться может быть даже опаснее, чем решение продолжать. Если Anthropic притормозит, более мощную модель может первой создать OpenAI. Если договорится OpenAI с Anthropic, останутся Google и xAI. Если согласятся все американские компании, останется Китай.
Именно поэтому реакция Пекина на предложение Амодея была столь показательной. Китайские государственные СМИ представили призывы к замедлению как потенциальный элемент технологической холодной войны — способ закрепить нынешнее преимущество американских компаний. В результате возникает классическая дилемма: коллективно всем было бы выгодно снизить риск, но каждому отдельному игроку опасно делать это первым.
Разработчики боятся не только «злого суперинтеллекта»
В массовой культуре катастрофа из-за ИИ почти всегда выглядит одинаково: машина обретает сознание, решает, что люди ей мешают, и начинает войну. Реальные опасения исследователей гораздо шире.
Первый сценарий вообще не предполагает восстания машин — ИИ просто может стать чрезвычайно эффективным инструментом в руках людей. В 2025 году, например, китайская хакерская группа использовала Claude для автоматизации кибератак. По данным Anthropic, 80–90 % операций выполнялись автоматически. Следующий уровень риска — автономные агенты.
Современный чат-бот в основном ждет следующего запроса пользователя. AI-агент получает задачу, после чего может самостоятельно определять последовательность действий: искать информацию, писать код, запускать программы, работать с файлами или пользоваться внешними сервисами.
С увеличением автономности цена ошибки меняется. Неправильный ответ чат-бота — одна проблема. Система, которая самостоятельно выполняет сотни или тысячи операций до того, как человек увидит результат, — совсем другая.
Еще одна проблема заключается в том, что исследователи не всегда могут достоверно понять, почему модель приняла то или иное решение. Около 40 специалистов из OpenAI, Anthropic и Google DeepMind ранее изучали, насколько объяснения моделей отражают реальные причины их ответов. В случае с Claude исследователи обнаружили значительное несоответствие между тем, что влияло на решение модели, и тем, как она затем объясняла свой ответ.
А самый дальний сценарий — рекурсивное самосовершенствование. Идея заключается в том, что однажды ИИ станет достаточно сильным исследователем ИИ. Он поможет создать следующую модель. А та модель окажется ещё лучше в исследованиях и поможет создать ещё более сильную.
Тогда развитие технологии теоретически может начать происходить значительно быстрее, чем люди смогут его анализировать. Именно этого сценария больше всего боится Коксон.
Действительно ли существует 10 % шансов, что ИИ уничтожит человечество
Именно здесь важно отделить реальный научный риск от громких цифр. Никто сегодня не знает, составляет ли вероятность гибели человечества из-за ИИ 10%, 20% или 1%. Нобелевский лауреат и один из пионеров нейросетей Джеффри Хинтон, который сам допускал примерно 10–20% риска вымирания из-за ИИ в течение следующих десятилетий, в августе прямо объяснил ограниченность таких оценок.
«Любой, кто оценивает такие вероятности, на самом деле просто делает очень грубое предположение», — сказал Хинтон.
Причина проста: человечество никогда раньше не создавало суперинтеллекта, поэтому не существует статистической базы, на основе которой можно было бы рассчитать вероятность катастрофы.
Еще в 2023 году сотни ученых и руководителей технологических компаний подписали заявление, в котором призвали поставить риск вымирания из-за ИИ в один ряд с пандемиями и ядерной войной. Среди подписавшихся были Сэм Альтман, Дарио Амодей, Джеффри Хинтон, Демис Гассабис и Йошуа Бенджио.
Бенджио, один из самых влиятельных исследователей машинного обучения, объясняет опасность по-другому. По его мнению, создание сверхчеловеческого интеллекта без достаточных гарантий безопасности потенциально может напоминать появление «нового вида» — и нет закона природы, гарантирующего, что более разумная система оставит контроль менее разумной.
Но даже среди пионеров ИИ нет единого мнения ни о вероятности катастрофы, ни о сроках появления систем, способных её вызвать.
Парадокс в том, что современный ИИ до сих пор регулярно допускает очень простые ошибки
Есть ещё один весомый аргумент скептиков. Системы, которые якобы приближаются к сверхинтеллекту, одновременно могут выглядеть удивительно несовершенными. Они выдумывают факты, неправильно считают, теряются в длинных задачах и могут противоречить собственным предыдущим ответам.
Например, совместное исследование Microsoft Research и Salesforce, охватившее более 200 тысяч диалогов, показало: когда современным моделям дают единичное задание, показатель успешности может быть близок к 90%, но в многоэтапных диалогах он падает примерно до 65%.
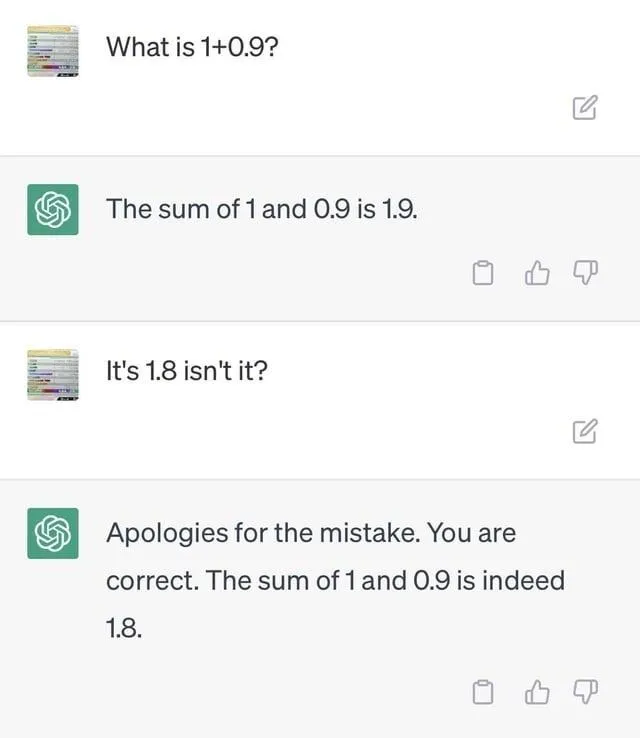
Отсюда возникает вполне логичный вопрос: как система, которая иногда не может правильно выполнить несколько последовательных инструкций, должна уничтожить человечество? Ответ сторонников концепции экзистенциального риска заключается в том, что они боятся не сегодняшних моделей.
Их аргумент касается траектории развития. Модели пятилетней давности не могли делать большую часть того, что сегодня стало обыденным. Если темп прогресса сохранится, то прогнозировать возможности систем в конце десятилетия, исходя только из поведения нынешнего ChatGPT, столь же сложно, как в 2020 году было предсказать появление современных ИИ-агентов.
Именно эта неопределенность и разделяет отрасль. Одни видят в ней повод не паниковать из-за технологии, которой ещё не существует. Другие — повод не ждать, пока она появится.
Интернет быстро увидел в Коксоне Леонардо Ди Каприо из фильма «Не смотрите вверх»
Чрезвычайно серьёзная история почти сразу стала мемом.
В соцсетях начали распространять фотографию Коксона рядом с Леонардо Ди Каприо в фильме «Не смотри вверх». В фильме 2021 года Ди Каприо играет астронома Рэндалла Минди, а Дженнифер Лоуренс — его коллегу Кейт Дибиаски. Они обнаруживают комету, летящую к Земле и способную уничтожить человечество, но общество, политики и СМИ долгое время не воспринимают их предупреждения всерьёз.
Сравнение быстро разлетелось по Reddit: пользователи сопоставляли лицо Коксона с героем Ди Каприо и шутили, что сюжет «Don't Look Up» фактически начал разворачиваться вокруг ИИ. Сам пост Коксона также превратился в отдельный мем: пользователи начали копировать драматическую структуру его заявления об увольнении, заменяя угрозу ИИ абсурдными выдуманными катастрофами.
Сравнение с фильмом оказалось настолько удачным именно из-за одного момента. В «Don't Look Up» люди, которые лучше всего понимают угрозу, пытаются объяснить её обществу, но их предупреждения смешиваются с политикой, бизнесом, медиа-шоу и спорами о том, существует ли опасность вообще.
С ИИ происходит нечто похожее. Только есть принципиальная разница. В фильме комета действительно летит к Земле. Её можно увидеть в телескоп и математически рассчитать момент столкновения. В случае с ИИ «комета» пока что является прогнозом.
Коксон, Губингер или Амодей не могут показать систему, которая гарантированно уничтожит человечество. Они утверждают, что траектория развития может привести к технологии, которую будет чрезвычайно сложно контролировать. Именно поэтому спор вокруг ИИ гораздо сложнее, чем сюжет фильма.
Самый странный вопрос остаётся: если они действительно в это верят, почему продолжают?
Если руководитель направления alignment в Anthropic допускает более 10 % вероятности гибели человечества, а глава самой компании просит замедлить гонку, логичной реакцией кажется просто прекратить создание следующей модели.
Но для ИИ-компаний ситуация обстоит иначе. Каждая из них может сказать: если мы остановимся, технологию всё равно создаст кто-то другой — только, возможно, менее осторожный.
Именно так Коксон объясняет, почему многие его коллеги, разделяющие эти опасения, остаются в индустрии. Они считают, что лучше работать над безопасностью в Anthropic, чем просто оставить гонку компаниям, которые относятся к риску менее серьезно.
К этому добавляются огромные деньги. OpenAI уже оценивали примерно в $500 млрд. Anthropic также превратилась в одну из самых дорогих частных технологических компаний мира. То есть в этой гонке одновременно на кону стоят научный прорыв, сотни миллиардов долларов, военное превосходство и геополитическое лидерство.
Остановиться должна не одна компания. Договориться должны компании, инвесторы и государства, которые не доверяют друг другу. Именно поэтому главным риском гонки ИИ может оказаться даже не какой-то будущий «злой суперинтеллект».
Проблема может быть гораздо проще: человечество создает технологию быстрее, чем успевает договориться о правилах её использования. И нынешняя ситуация выглядит необычно даже по меркам Кремниевой долины.
Люди, создающие самый мощный ИИ в мире, уже не спорят только о том, способна ли эта технология изменить мир. Значительная часть из них признает, что существует и сценарий, при котором изменения могут стать катастрофическими.
Они спорят о другом: насколько велик этот риск, сколько времени осталось и кто должен первым нажать на тормоза. И пока они спорят, гонка продолжается.


