
纽约创建互动记者头像——TechCrunch
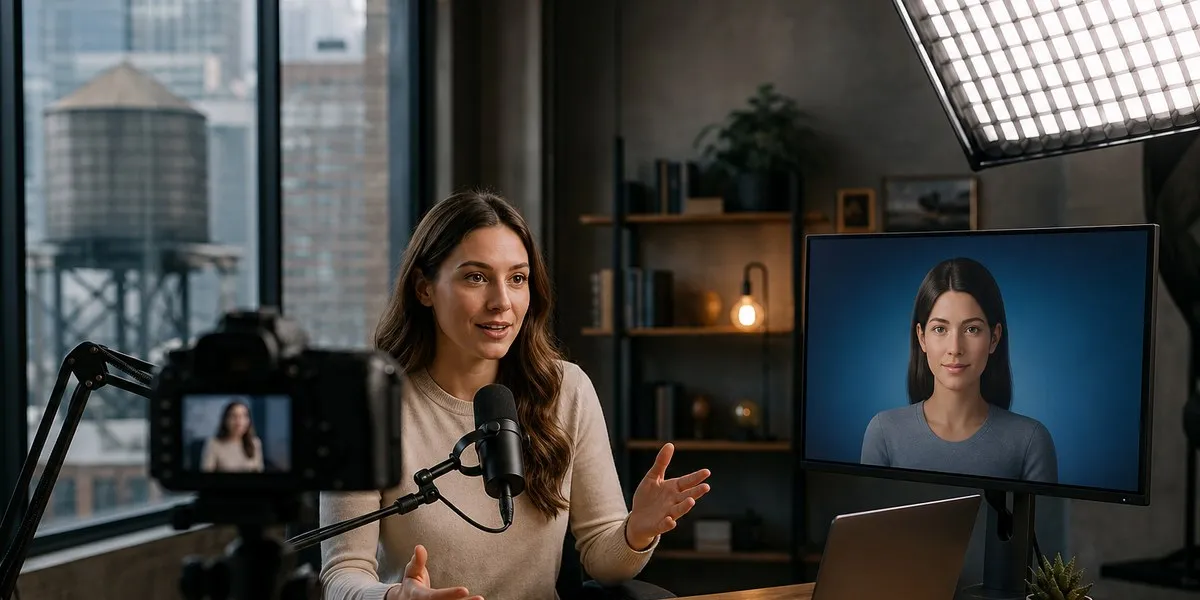
在纽约,TechCrunch文章的作者测试了由Synthesia创建的互动数字头像。该头像被训练为仅回答与这名记者文章相关的问题,该文章探讨了为何获得风险投资支持的初创企业比没有此类融资的公司更常诉诸欺诈。
为创建该头像,Synthesia在其办公室为作者拍摄了照片,并录制了约两分钟的声音。该公司准备了多个版本:可朗读输入脚本的个人头像,以及能够聆听问题并作出回答的互动头像。每个版本均制作了戴眼镜和不戴眼镜的版本。
头像如何运作
互动头像使用语音转文本模型、语言模型、语音合成以及视频模型的组合,视频模型会在回答时为图像添加动画。Synthesia使用自己的视频和语音模型,但也允许客户选择Cartesia、ElevenLabs、Google或OpenAI提供的替代方案。
更多最新消息请关注 UA.News Telegram 频道 Telegram.
这名记者的头像以确定性模式运行:它只会在其训练所依据的文章范围内回答。面对有关个人生活或过往工作的提问时,它没有作出实质性回答,而是将对话引回文章主题。创建这些头像花了数天时间。
Synthesia的产品
Synthesia最初总部设在英国,开发配备AI头像的企业视频。去年,该公司表示其年度经常性收入已超过1亿美元,今年其估值达到40亿美元。
该公司的产品包括一个根据文本脚本创建视频的平台、用于互动员工培训的Roleplay Sessions服务,以及一个用于将视频和语音模型与其他服务相结合的API平台。文章作者指出,这项实验让他开始思考在新闻业中使用数字孪生体,而信任仍是其中的关键要素。



