
В Нью-Йорке создали интерактивный аватар журналиста — TechCrunch
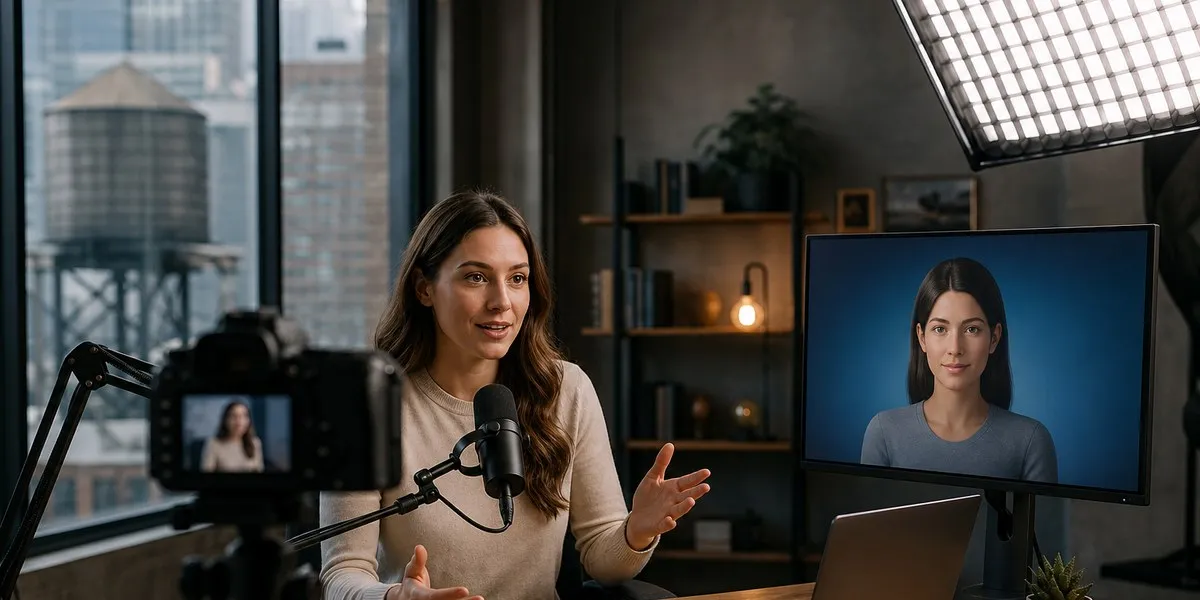
В Нью-Йорке автор материала TechCrunch протестировал интерактивный цифровой аватар, созданный компанией Synthesia. Аватар обучили отвечать на вопросы только о статье журналиста о причинах, по которым стартапы при поддержке венчурного капитала чаще прибегают к мошенничеству, чем компании без такого финансирования.
Для создания аватара в офисе Synthesia сделали фотографии автора и записали около двух минут его голоса. Компания подготовила несколько версий: персональные аватары, которые озвучивают введенный сценарий, и интерактивные, способные слушать вопросы и отвечать на них. Каждый вариант создали с очками и без них.
Как работает аватар
Интерактивный аватар использует сочетание моделей преобразования речи в текст, языковой модели, синтеза голоса и видеомодели, которая анимирует изображение во время ответа. Synthesia применяет собственные видео- и голосовые модели, но также позволяет клиентам выбирать альтернативные решения от Cartesia, ElevenLabs, Google или OpenAI.
Больше актуальных новостей — в Telegram-канале UA.News Telegram.
Аватар журналиста работает в детерминированном режиме: он отвечает только в пределах материала, на котором его обучали. На вопросы о личной жизни или предыдущей работе он не отвечал по существу, а возвращал разговор к теме статьи. Создание аватаров заняло несколько дней.
Продукты Synthesia
Synthesia, изначально базировавшаяся в Великобритании, разрабатывает корпоративные видео с ИИ-аватарами. В прошлом году компания сообщала, что ее годовой регулярный доход превысил $100 млн, а в этом году ее оценка достигла $4 млрд.
Среди продуктов компании — платформа для создания видео по текстовому сценарию, сервис Roleplay Sessions для интерактивного обучения сотрудников и API-платформа для объединения видео- и голосовых моделей с другими сервисами. Автор материала отметил, что этот эксперимент заставил его задуматься об использовании цифровых двойников в журналистике, где ключевым элементом остается доверие.




